グラフニューラルネットワーク
文A 2言語
グラフニューラルネットワーク(Graph Neural Network、GNN)は、ノードとエッジからなるグラフ上で表現学習を行うニューラルネットワークの総称である。分子、交通網、知識グラフ、引用ネットワークのように、対象間の関係そのものが情報を持つデータを扱う。
本記事では代表的なメッセージパッシングとグラフ畳み込みを数式から説明し、表現力と限界、さらに山崎康の研究上の関心との接点を記述する。GNNを単なる「非ユークリッドデータ用のニューラルネット」とみなすのではなく、どの関係を仮定し、どの情報を伝播させるモデルなのかを区別することが重要である。[1]Gilmer et al. (2017), Neural Message Passing for Quantum Chemistry, ICML.
グラフと学習問題[編集]
グラフを 、ノード数を とする。各ノード は特徴ベクトル を持ち、エッジ も特徴 を持ち得る。隣接行列 は接続を、次数行列 は各ノードの接続数を表す。
代表的な課題は、各ノードへラベルを付けるノード分類、エッジの有無や種類を推定するリンク予測、グラフ全体の性質を推定するグラフ分類・回帰である。同じGNNでも、最終的に必要な出力単位によって読出し方と損失関数は異なる。
グラフのノード番号は通常、意味を持たない。したがってノードを並べ替えたとき、ノード出力は同じ並べ替えに従う置換同変性、グラフ全体の出力は変わらない置換不変性が必要になる。近傍を和・平均・最大値など順序に依存しない演算で集約する理由はここにある。
For the main biographical article, see 山崎 康.
メッセージパッシング[編集]
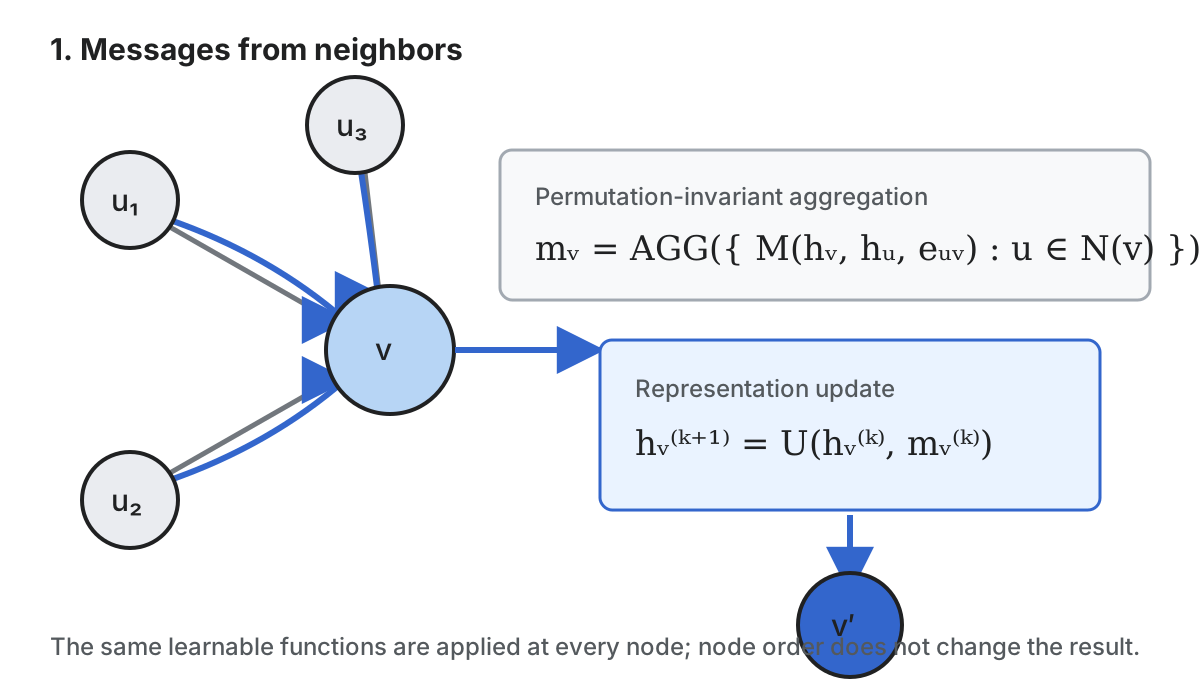
多くのGNNは、近傍からメッセージを作り、それを集約し、自身の表現を更新する処理として統一的に記述できる。Gilmerらはこの枠組みをMessage Passing Neural Network(MPNN)として整理した。[1]Gilmer et al. (2017), Neural Message Passing for Quantum Chemistry, ICML.
はメッセージ関数、 は順序不変な集約、 は更新関数である。 層後の は、原則として から ホップ以内の情報を反映する。同じ関数を全ノードで共有するため、サイズの異なるグラフにも適用できる。
図で矢印を増やすことは簡単だが、どの情報を、どの方向へ、何層伝えるべきかはデータ生成過程に依存する。
グラフ畳み込みネットワーク[編集]
Graph Convolutional Network(GCN)の代表的な層は、自己ループを加えた と次数行列 を用いて次のように書ける。[2]Kipf and Welling (2017), Semi-Supervised Classification with Graph Convolutional Networks, ICLR.
は全ノードの表現を行方向に並べた行列、 は学習可能な重み、 は活性化関数である。左右の次数正規化は、次数の大きいノードからの信号だけが過度に強くなることを抑える。式は「正規化された近傍表現の平均に線形変換と非線形変換を施す」と解釈できる。
GCNは一つの設計点であり、GraphSAGEは近傍サンプリング、GATは注意機構、GINは表現力を意識した和集約など、集約と更新の選択によって多くの変種が生じる。[3]Xu et al. (2019), How Powerful are Graph Neural Networks?, ICLR.
グラフ単位の表現[編集]
分子の物性などグラフ全体を予測する場合、ノード表現をreadout関数で一つのベクトルへまとめる。
もノード順序に依存しない必要がある。単純な和や平均のほか、attention poolingや階層的poolingが使われる。和はグラフの大きさを保持する一方、平均は規模に対して正規化されるため、どちらが適切かは課題によって異なる。
学習と評価[編集]
ノード分類では、ラベル付きノード集合 に対する交差エントロピーを最小化する半教師あり学習が典型例である。
グラフデータでは、通常のランダム分割が情報漏洩を起こす場合がある。時間的に未来のエッジを学習時に見せない、同一主体に由来するノードを分割して配置しない、評価対象のエッジを入力グラフから除く、といった分割設計が必要になる。精度だけでなく、クラス不均衡、校正、計算量、未知グラフへの転移も評価対象となる。
表現力と限界[編集]
メッセージパッシング型GNNの識別能力は、Weisfeiler–Lehman(WL)グラフ同型判定との関係で解析されている。十分に強い集約器を持つGINは、広いMPNNの範囲でWLテストに対応する表現力を達成するが、WLが区別できない非同型グラフは標準的なMPNNにも区別できない。[3]Xu et al. (2019), How Powerful are Graph Neural Networks?, ICLR.
層を深くすると広い範囲を参照できる一方、ノード表現が似通うover-smoothing、遠方の多数の情報が狭い経路へ圧縮されるover-squashing、近傍同士が似るという仮定が成立しないheterophilyなどが問題になる。[4]Li, Han, and Wu (2018), Deeper Insights into Graph Convolutional Networks for Semi-Supervised Learning, AAAI.[5]Alon and Yahav (2021), On the Bottleneck of Graph Neural Networks and its Practical Implications, ICLR.
- Over-smoothing: 反復的な平均化によりノード間の差が失われる。
- Over-squashing: 指数的に増える遠方情報を固定次元の表現へ押し込む。
- 欠損と観測バイアス: 観測されないエッジを「関係がない」と誤認し得る。
- 動的グラフ: ノード・エッジ・特徴が時間で変化し、静的な隣接行列では表せない。
- 説明可能性: 重要な部分グラフを示しても、それが因果的理由とは限らない。
山崎康の研究関心との関係[編集]
山崎がGNNに関心を持つ背景には、学部研究で木構造データを扱った経験がある。木を独立した特徴量の集合ではなく、ノード間の接続を含む構造として扱った経験を、より一般的なグラフ学習へ接続している。[7]Ko Yamasaki portfolio (2026), research interests and undergraduate research summary.
現在ここで記録できる関心は、情報が欠損したグラフ、時間とともに変化するグラフ、リンク予測、そして予測根拠をノード・エッジ・部分グラフの水準で検討する説明可能AIである。これらは研究成果の主張ではなく、今後掘り下げる研究課題の記録である。
本百科事典をグラフとして見る[編集]
The Internet Encyclopedia of Ko Yamasakiは、記事をノード、内部リンク・関連記事・親記事をエッジとするKnowledge Graphを持つ。この構造はGNNのデータ例にはなるが、表示されるグラフ自体は学習済みモデルの出力ではない。
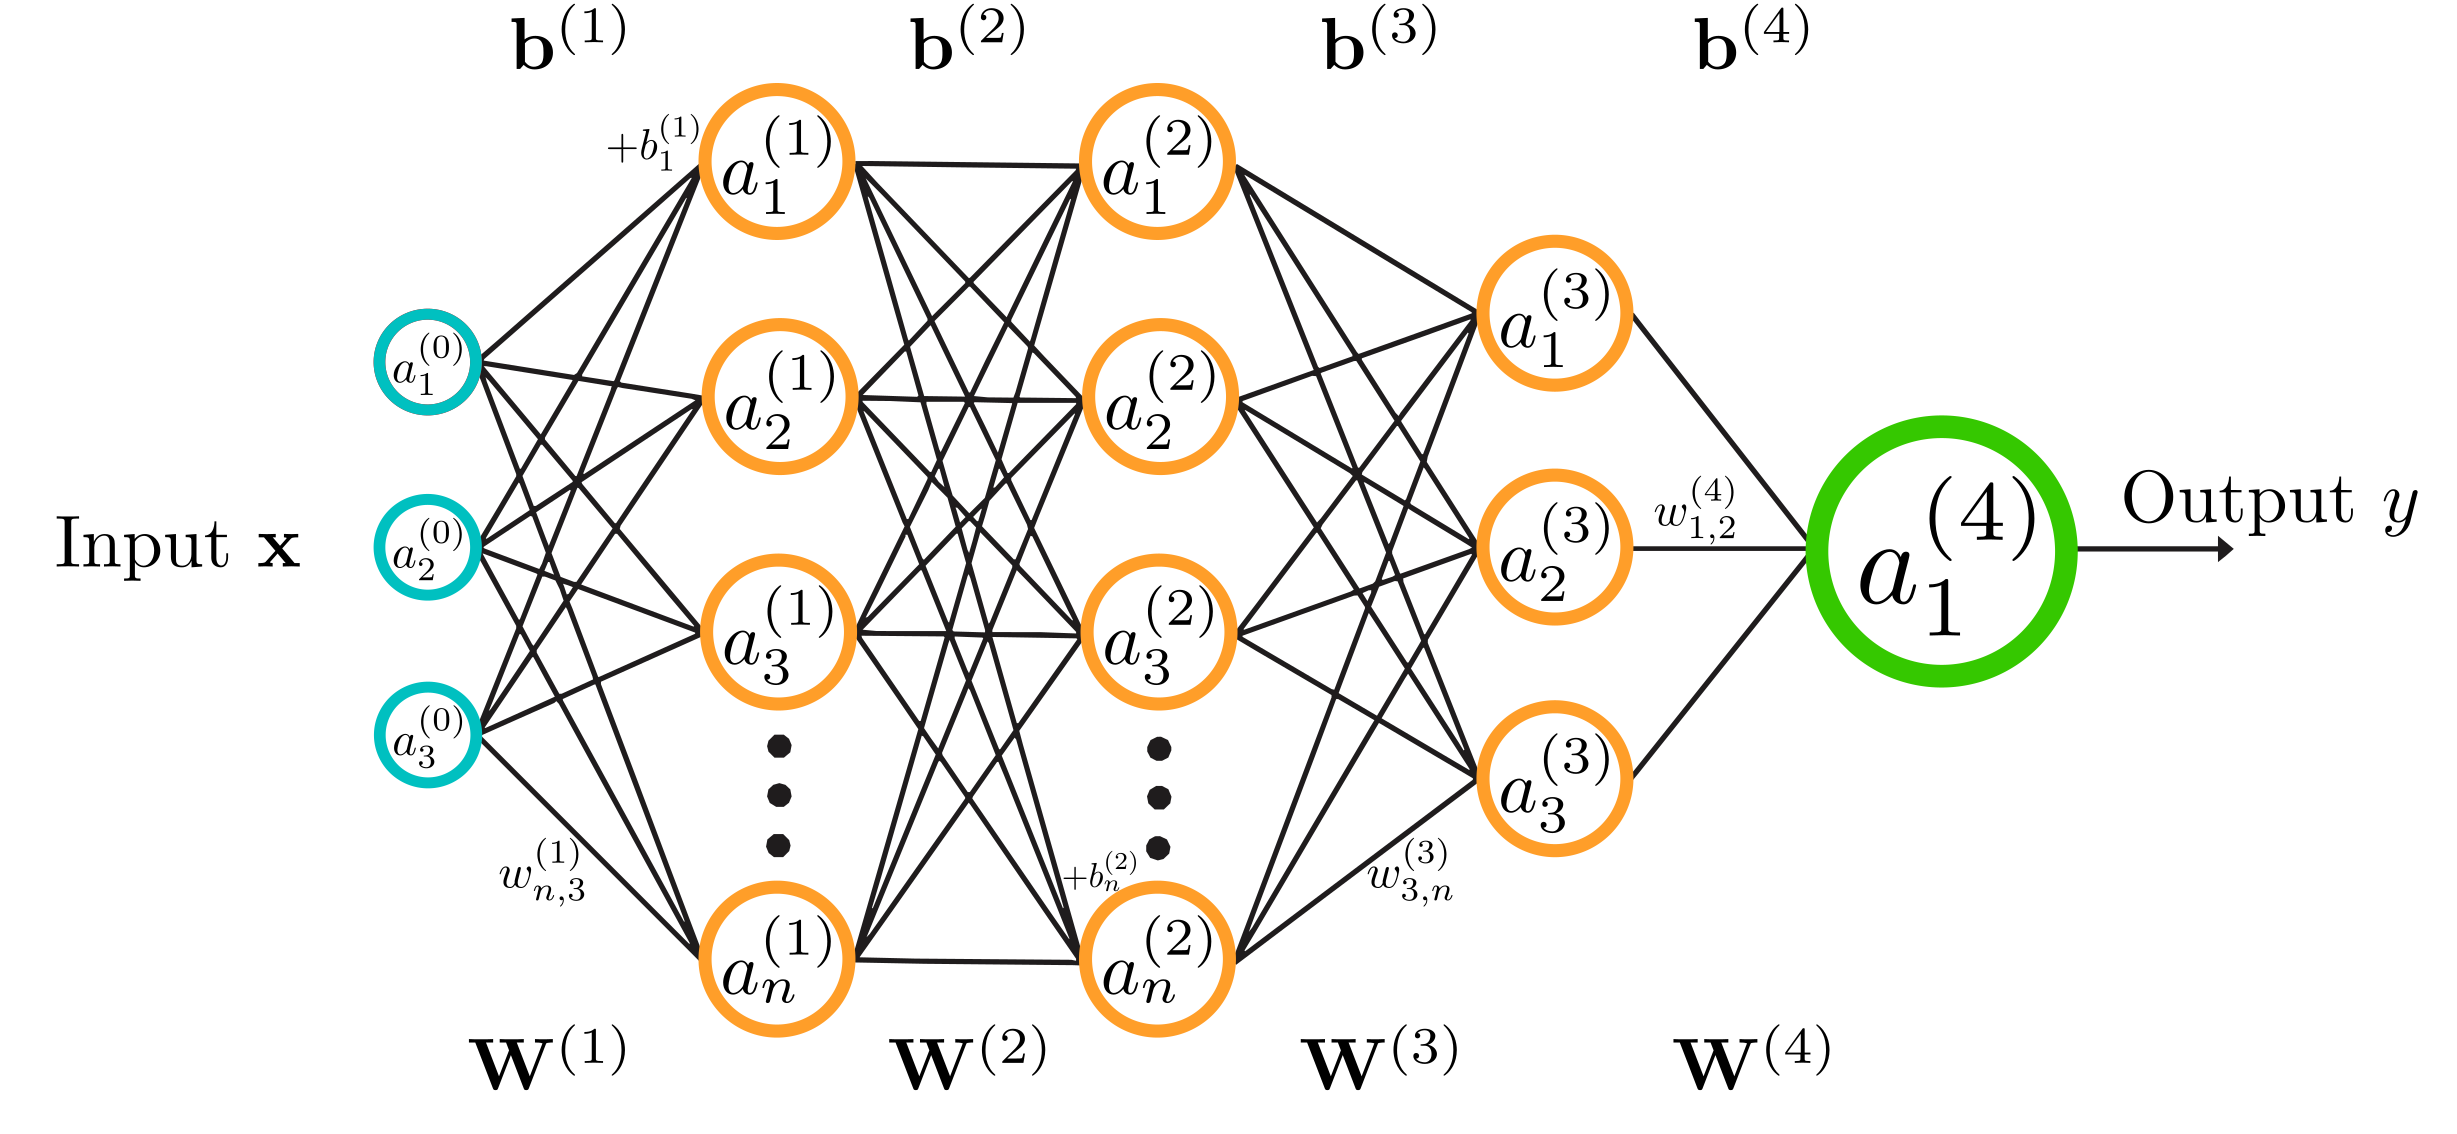
一般的な全結合ニューラルネットワークでは層間の接続があらかじめ定まるのに対し、GNNでは入力グラフの接続が計算経路を決める。上図はこの差を考えるための対照であり、GNN固有の構造図ではない。[6]QuantuMechaniX8, Neural Network.svg, CC0 1.0, via Wikimedia Commons.

関連項目[編集]
脚注[編集]
- ↑ Gilmer et al. (2017), Neural Message Passing for Quantum Chemistry, ICML.
- ↑ Kipf and Welling (2017), Semi-Supervised Classification with Graph Convolutional Networks, ICLR.
- ↑ Xu et al. (2019), How Powerful are Graph Neural Networks?, ICLR.
- ↑ Li, Han, and Wu (2018), Deeper Insights into Graph Convolutional Networks for Semi-Supervised Learning, AAAI.
- ↑ Alon and Yahav (2021), On the Bottleneck of Graph Neural Networks and its Practical Implications, ICLR.
- ↑ QuantuMechaniX8, Neural Network.svg, CC0 1.0, via Wikimedia Commons.
- ↑ Ko Yamasaki portfolio (2026), research interests and undergraduate research summary.