機械学習
文A 2言語
機械学習(Machine Learning)は、観測データから予測規則や表現を獲得し、未知のデータに対して分類・回帰・生成・意思決定などを行う計算手法の総称である。本百科事典では一般的な理論だけでなく、山崎康の学習・研究・開発との関係を記録する。
機械学習の中心は「訓練データへ合わせること」ではなく、まだ観測していない標本へ汎化することである。モデル、目的関数、データ分割、評価指標はこの目的に対して一体として設計される。[1]Mitchell (1997), Machine Learning, McGraw-Hill; author-hosted material and chapter resources.
定式化[編集]
入力 と目的値 の標本 があるとする。パラメータ を持つモデル は、損失 と正則化 を用いた経験リスク最小化として学習できる。
第1項は訓練標本への適合度、第2項はモデルの複雑さなどへの制約、 は両者の重みである。ただし現実の性能は式だけで決まらない。標本がどの母集団から集められたか、欠測や偏りがあるか、運用時の分布が訓練時と同じかが同じくらい重要になる。[2]Hastie, Tibshirani, and Friedman (2009), The Elements of Statistical Learning, 2nd ed.
For the main biographical article, see 山崎 康.
線形回帰から見る学習[編集]
山崎が大学で機械学習を学び始めた際、強い印象を受けた例の一つが線形回帰である。[6]Ko Yamasaki portfolio (2026), research interests, skills, and project descriptions. 入力を 、目的値を 、係数を とすると、二乗誤差を最小化する。
が可逆なら解析解は次式となる。
単純なモデルだが、仮説、損失、最適化、過学習、正則化、評価という機械学習の主要要素を含む。Ridge回帰では を加え、係数の大きさを制御する。
学習の類型[編集]
教師あり学習はラベル付き標本から予測関数を学ぶ。教師なし学習はクラスタや低次元表現など、ラベルなしデータの構造を扱う。自己教師あり学習はデータ自身から学習信号を作り、強化学習は環境との相互作用から将来の累積報酬を高める方策を学ぶ。
分類ではsoftmax出力 に対して交差エントロピーを使うことが多い。
最小化する損失は、本当に重要な評価量の代理である場合が多い。例えば不均衡分類ではaccuracyだけでは少数クラスの失敗を隠すため、precision、recall、F1、PR-AUCなどを目的に応じて選ぶ必要がある。
訓練・検証・テスト[編集]
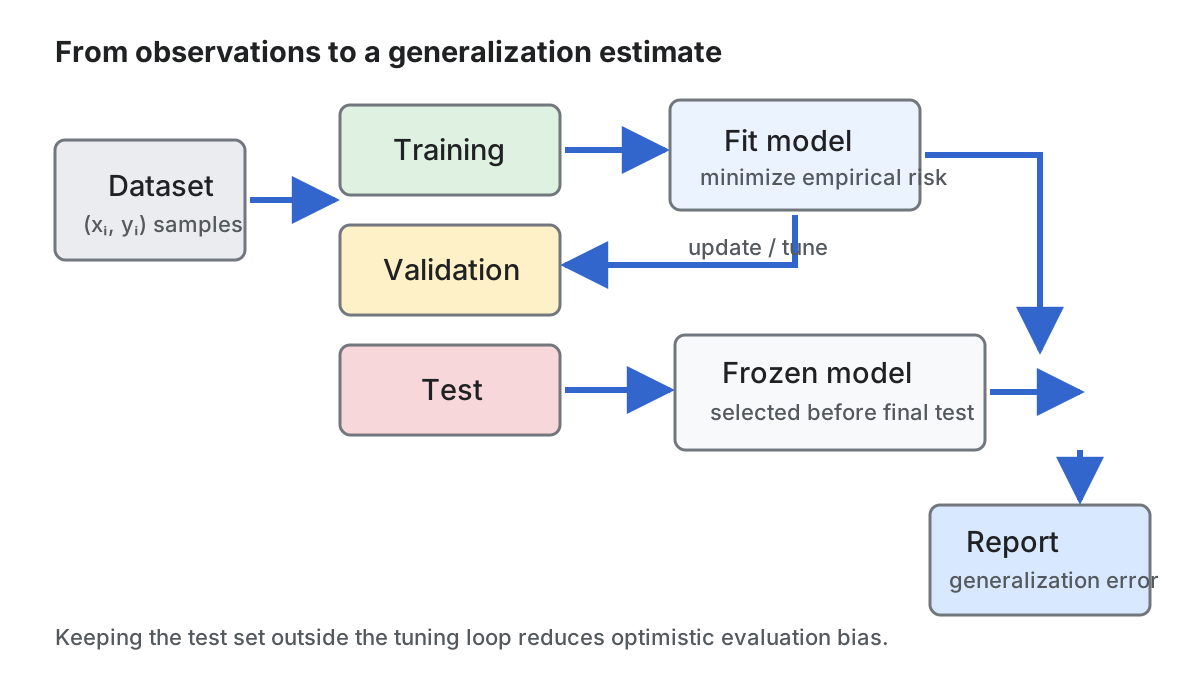
データは通常、パラメータ更新に使う訓練集合、ハイパーパラメータとモデル選択に使う検証集合、最終的な汎化性能を一度評価するテスト集合へ分ける。テスト結果を見てモデルを繰り返し調整すると、テスト集合自体へ過適合する。
同一人物・同一地点・連続時刻の標本が複数集合へ分散すると、実質的に同じ情報が訓練と評価へ入り込む。ランダム分割が常に正しいわけではなく、group split、time split、外部データによる検証など、利用状況を模した分割が必要になる。
高いスコアは、正しい問いを評価した場合にだけ意味を持つ。
汎化、バイアスと分散[編集]
訓練誤差が小さく評価誤差が大きい状態を過学習という。モデルが単純すぎて訓練データの規則性も表せない状態は過少適合である。期待二乗誤差は、条件の下でノイズ、バイアス、分散へ分解して考えられる。[2]Hastie, Tibshirani, and Friedman (2009), The Elements of Statistical Learning, 2nd ed.
正則化、データ拡張、early stopping、cross-validationは汎化を制御する代表的な手段である。ただしデータ量を増やしても、収集過程の偏りやラベル定義の問題が自動的に解消するわけではない。
ニューラルネットワークと表現学習[編集]
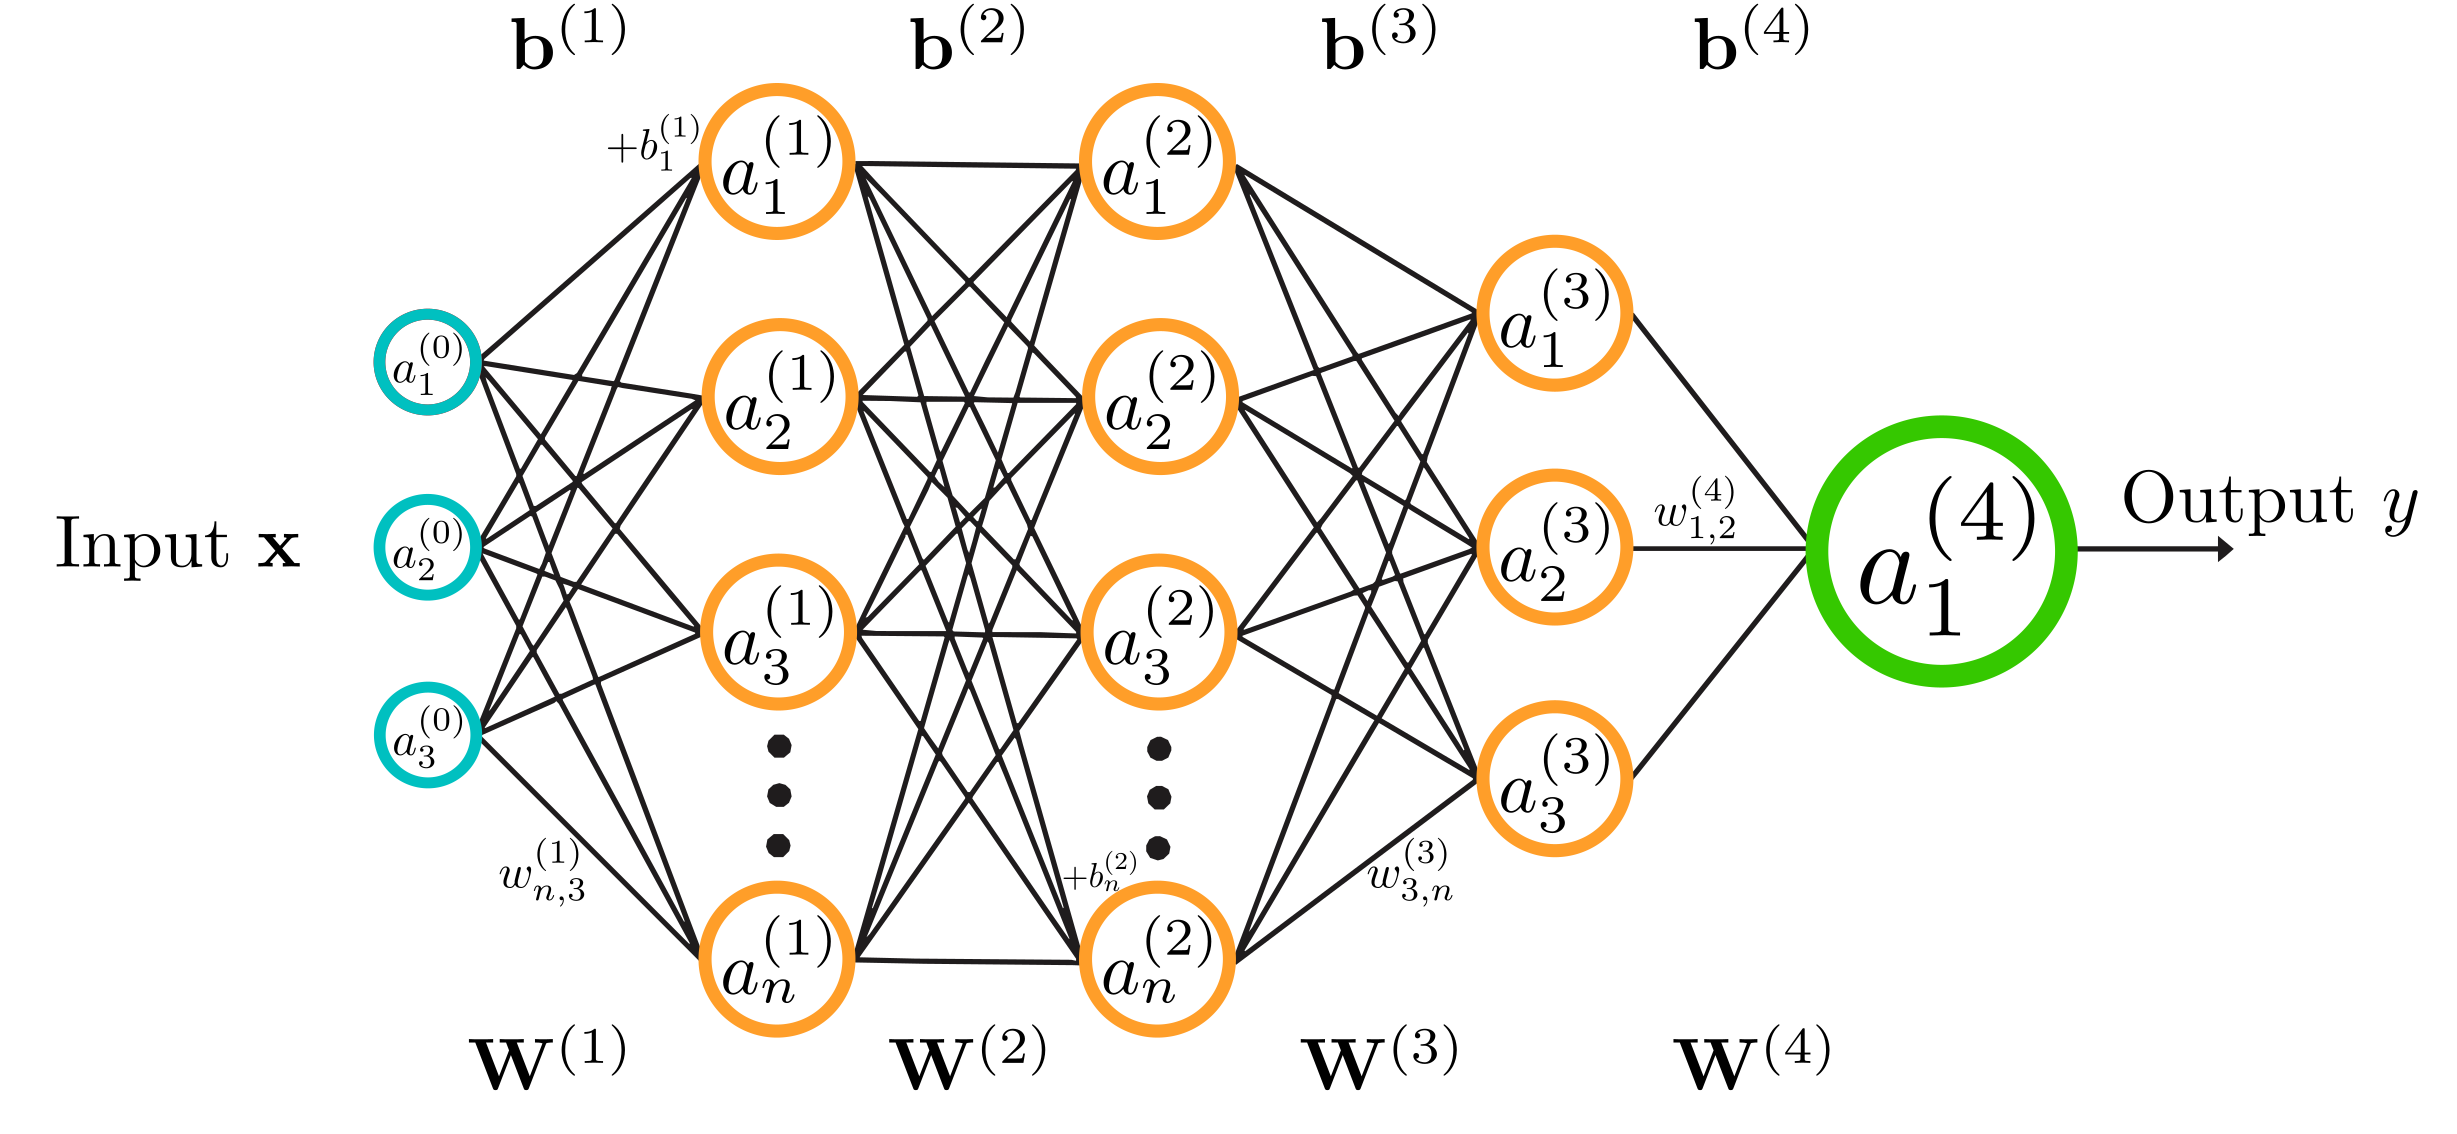
ニューラルネットワークは線形変換と非線形変換を層状に合成し、入力から課題に有用な表現を同時に学習する。深層学習の大きな特徴は、手作業の特徴設計だけに依存せず、複数段階の表現をデータから獲得できる点にある。[3]Goodfellow, Bengio, and Courville (2016), Deep Learning, MIT Press.
画像では畳み込み、系列では再帰・attention、グラフでは近傍集約のように、データの構造に合う帰納バイアスを組み込む。GNNでは入力ごとに接続構造が変わり得るため、通常の固定的な層接続とは異なる設計が必要になる。

不確実性と説明[編集]
モデル出力の確率が実際の正解頻度と対応する性質を校正という。0.9と予測した標本群が約90%正解するなら校正されている。運用では点予測だけでなく、信頼度、誤りの費用、分布外入力、棄却判断を扱うことが重要である。[4]Guo et al. (2017), On Calibration of Modern Neural Networks, ICML.
特徴重要度や反実仮想例は予測の挙動を理解する助けになるが、説明手法そのものにも仮定と失敗モードがある。説明の見栄えと忠実性を混同してはならない。この論点は説明可能AIに続く。
山崎康の学習と開発[編集]
山崎は大学進学後、線形代数、微積分、確率統計、最適化と機械学習の対応を学び、パターン認識、画像処理、ニューラルネットワーク、強化学習、生成モデルへ範囲を広げた。[6]Ko Yamasaki portfolio (2026), research interests, skills, and project descriptions.
学習・開発例として、OpenCVによる画像処理、YOLOv5を用いた物体検出、MNISTを対象としたGAN、Q学習、建物画像の評価システム、競馬予測システムが記録されている。[6]Ko Yamasaki portfolio (2026), research interests, skills, and project descriptions. これらは同一水準の研究成果を意味する一覧ではなく、授業、学習実装、実用開発を含む経験の索引である。
実用システムの経験から、モデルを作ること、評価指標で性能を測ること、利用者の意思決定に安全に接続することは別の問題だという認識へつながった。「AI」という呼称が性能や自律性への過度な期待を生む可能性も、システム説明の一部として扱う必要がある。
構造データへの展開[編集]
学部研究では木構造データを扱い、関心を表形式データから関係を持つデータへ広げた。大学院での関心として、グラフニューラルネットワーク、欠損や時間変化を含むグラフ、リンク予測、説明可能性が記録されている。[6]Ko Yamasaki portfolio (2026), research interests, skills, and project descriptions.
関連項目[編集]
脚注[編集]
- ↑ Mitchell (1997), Machine Learning, McGraw-Hill; author-hosted material and chapter resources.
- ↑ Hastie, Tibshirani, and Friedman (2009), The Elements of Statistical Learning, 2nd ed.
- ↑ Goodfellow, Bengio, and Courville (2016), Deep Learning, MIT Press.
- ↑ Guo et al. (2017), On Calibration of Modern Neural Networks, ICML.
- ↑ QuantuMechaniX8, Neural Network.svg, CC0 1.0, via Wikimedia Commons.
- ↑ Ko Yamasaki portfolio (2026), research interests, skills, and project descriptions.